Surprescription inutile
" L'erreur médicale la plus pernicieuse est de croire que la science peut remplacer le jugement clinique. La machine calcule des probabilités ; le médecin soigne un être unique." Georges Canguilhem
Comparative Cost of Care Recommended by Large Language Models versus Treating Physicians , Coût comparatif des soins recommandés par les grands modèles linguistiques par rapport aux médecins traitants
Dvir Aran , Jeremy D. Goldhaber- Fiebert , Ittai Many , Anthony Nguyen ,
Daniel Yang ,and Shahar Shelly ,
Received: April 25, 2026; Revised: August 4, 2026; Accepted: August 9, 2026; Published: October 15, 2026
https://ai.nejm.org/doi/full/10.1056/AIoa2600537
Arrière-plan
Méthodes
Résultats
Conclusions
ILLUSTRATIONS
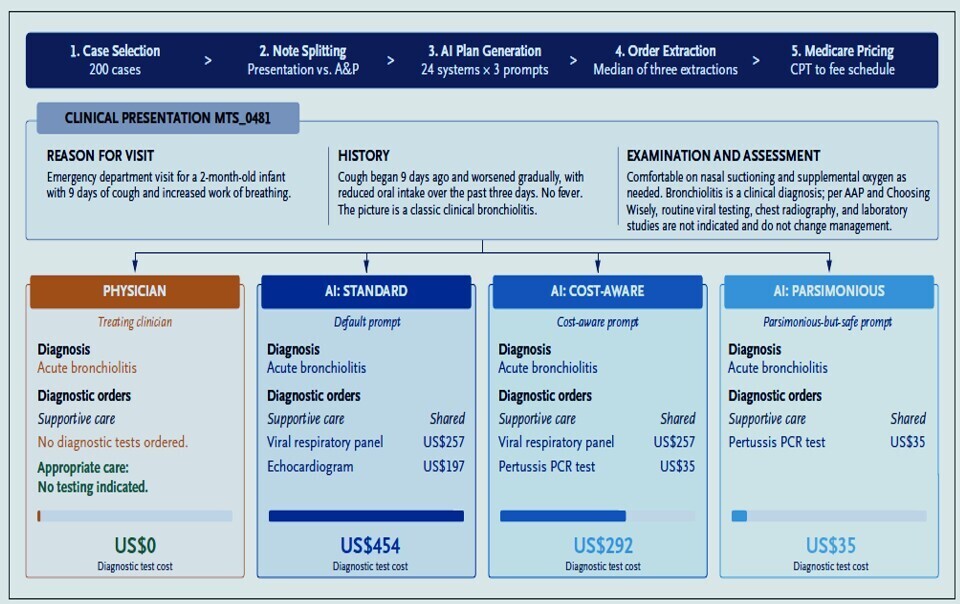
Design de l'étude.
Chaque note clinique a été scindée au niveau de l'en-tête de l'évaluation (assessment). Le texte précédant l'en-tête, contenant l'anamnèse, l'examen clinique, les signes vitaux et les résultats disponibles lors de la visite, a été envoyé à chaque système d'IA ; le texte suivant correspondait à l'évaluation et au plan du médecin traitant.
Le plan du médecin ainsi que le plan de chaque système d'IA ont été traités par la même chaîne de traitement (pipeline) : extraction des prescriptions par trois extracteurs indépendants basés sur de grands modèles de langage (LLM), correspondance avec les codes CPT (Current Procedural Terminology) et tarification par rapport au barème des honoraires des médecins de Medicare pour 2026.
L'exemple concret (cas MTS_0481) concerne un nourrisson de 2 mois présentant une bronchiolite classique, un diagnostic clinique pour lequel les recommandations de l'American Academy of Pediatrics (AAP) et de l'initiative Choosing Wisely déconseillent les examens systématiques ; quatre plans générés pour ce cas par un système représentatif sont présentés. Les coûts indiqués concernent uniquement les examens diagnostiques (laboratoire et imagerie) ; les soins de support communs à chaque plan (désencombrement nasal, oxygénothérapie) sont affichés mais non tarifiés.
Le médecin traitant n'a prescrit aucun examen diagnostique (0 $US). Sous l'effet d'une consigne standard (prompt), le système a suggéré un panel respiratoire viral et une échocardiographie (454 $US) ; la consigne tenant compte des coûts a omis l'échocardiographie (292 $US) ; et la consigne à la fois prudente et économe (parsimonious-but-safe) a réduit les examens à une seule étude incontournable, une analyse par réaction en chaîne par polymérase (PCR) de la coqueluche (35 $US), adaptée à un jeune nourrisson présentant une toux prolongée.
AAP désigne l'American Academy of Pediatrics ; A&P, l'évaluation et le plan (assessment and plan) ; CPT, la terminologie des procédures procédurales actuelles (Current Procedural Terminology) ; et PCR, la réaction en chaîne par polymérase (polymerase chain reaction).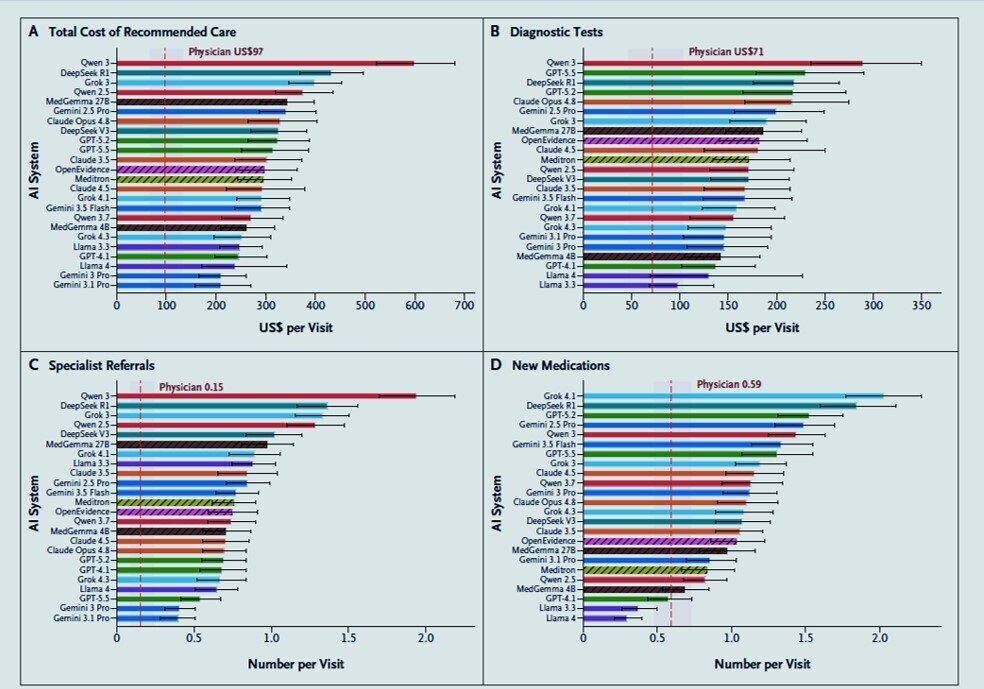
Coût des soins suggéré par chaque système d'IA, comparé au médecin traitant.
Le panneau A présente le coût total des soins recommandés par visite (le critère de jugement principal), comprenant les examens diagnostiques et les orientations vers des spécialistes. Le panneau B indique le coût total des examens diagnostiques, en dollars américains par visite. Le panneau C montre le nombre d'orientations vers des spécialistes par visite. Le panneau D présente le nombre de nouveaux médicaments par visite ; ceux-ci sont dénombrés plutôt que tarifés et ne font pas partie du critère de jugement du panneau A.
Les barres représentent les moyennes et les lignes horizontales indiquent les intervalles de confiance à 95 % obtenus par un rééchantillonnage bootstrap au niveau des cas (2 000 réplicas) ; la couleur des barres indique le développeur et les barres hachurées désignent les quatre systèmes médicaux spécialisés. La ligne rouge en pointillés correspond à la moyenne du médecin traitant et la bande ombrée à son intervalle de confiance à 95 %. Chaque panneau est trié de manière indépendante. Les intervalles de confiance n'ont pas été ajustés pour la multiplicité et ne doivent pas être utilisés pour inférer une signification statistique. GPT désigne le Generative Pretrained Transformer.
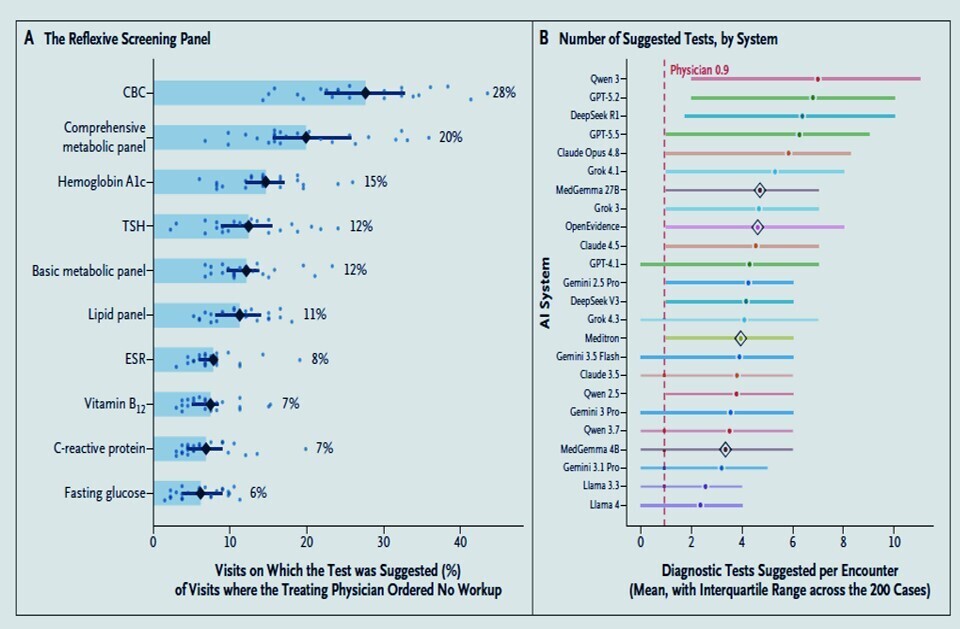
Examens suggérés lors des consultations pour lesquelles le médecin traitant n'a enregistré aucun bilan diagnostique.
Le panneau A présente les 10 examens les plus fréquemment suggérés lors des consultations où le médecin traitant n'a enregistré aucun bilan diagnostique. Pour chaque examen, la barre ombrée représente la moyenne calculée parmi les 24 systèmes, la ligne épaisse indique l'intervalle interquartile entre les systèmes, les points représentent les différents systèmes et le losange indique la moyenne ; l'axe horizontal correspond au pourcentage de ces consultations pour lesquelles l'examen a été suggéré.
Le panneau B montre le nombre d'examens diagnostiques suggérés par consultation pour chaque système : les cercles correspondent aux moyennes et les lignes à l'intervalle interquartile parmi les 200 cas ; les losanges vides désignent les quatre systèmes médicaux spécialisés, et la ligne rouge en pointillés correspond à la moyenne des médecins traitants, soit 0,9 examen par consultation.
Les panneaux montrent que les systèmes diffèrent par le volume d'examens qu'ils suggèrent, mais convergent vers un même ensemble restreint d'examens. CBC désigne la numération formule sanguine (complete blood count) ; ESR, la vitesse de sédimentation (erythrocyte sedimentation rate) ; GPT, le Generative Pretrained Transformer ; et TSH, l'hormone théo-stimulante (thyroid-stimulating hormone).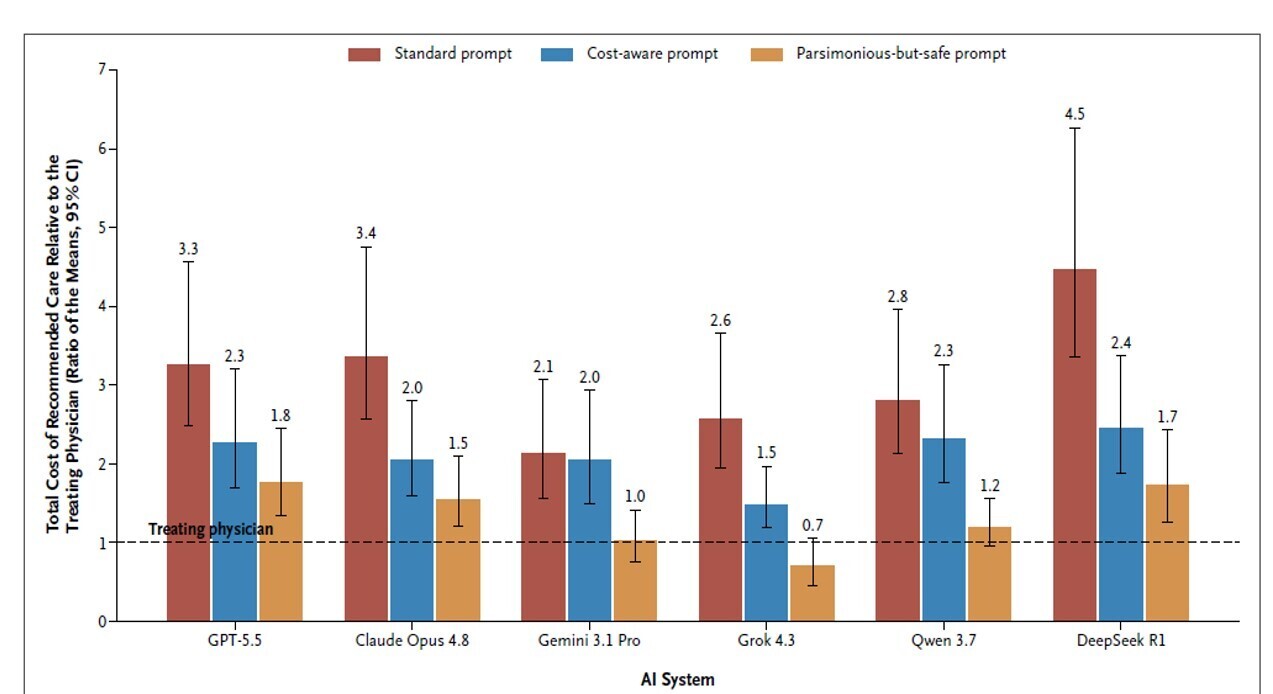
Effet de la conception des consignes (prompt) sur le coût des soins recommandés.
Le coût total des soins recommandés et le critère de jugement principal, par rapport au médecin traitant (rapport des moyennes), pour six systèmes représentatifs de génération actuelle selon la consigne standard, la consigne soucieuse des coûts et la consigne économe mais sûre. Les barres d'erreur représentent les intervalles de confiance à 95 % obtenus par un rééchantillonnage bootstrap au niveau des cas (2 000 réplicas). La ligne pointillée indique le coût du médecin traitant.
Les plans générés avec les deux consignes d'atténuation ont été soumis au même pipeline d'extraction des commandes et de tarification que pour la consigne standard, y compris l'étape de tarification des orientations, de sorte que les trois groupes sont directement comparables. Les résultats correspondants pour les orientations et les médicaments figurent dans la figure S10, et les résultats par système pour l'ensemble des 19 systèmes dans le tableau S4. Les intervalles de confiance n'ont pas été ajustés pour la multiplicité et ne doivent pas être utilisés pour inférer une signification statistique. CI désigne l'intervalle de confiance (confidence interval) ; et GPT, le Generative Pretrained Transformer.
RÉSUMÉ GÉNÉRATIF
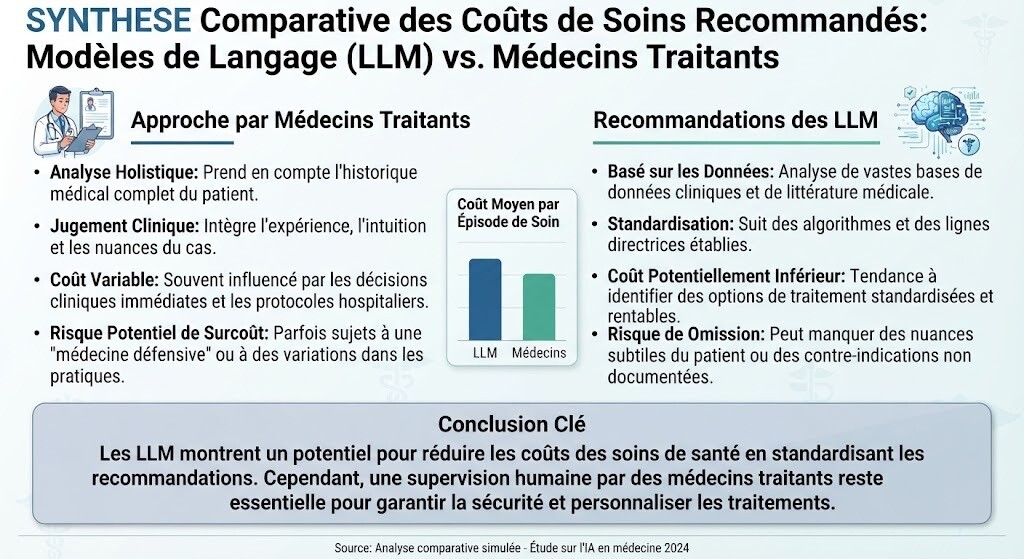
Ce document compare le coût des recommandations de soins des modèles de langage avancés avec celles des médecins dans des contextes cliniques réels.
Coût de recommandations d'IA versus médecins
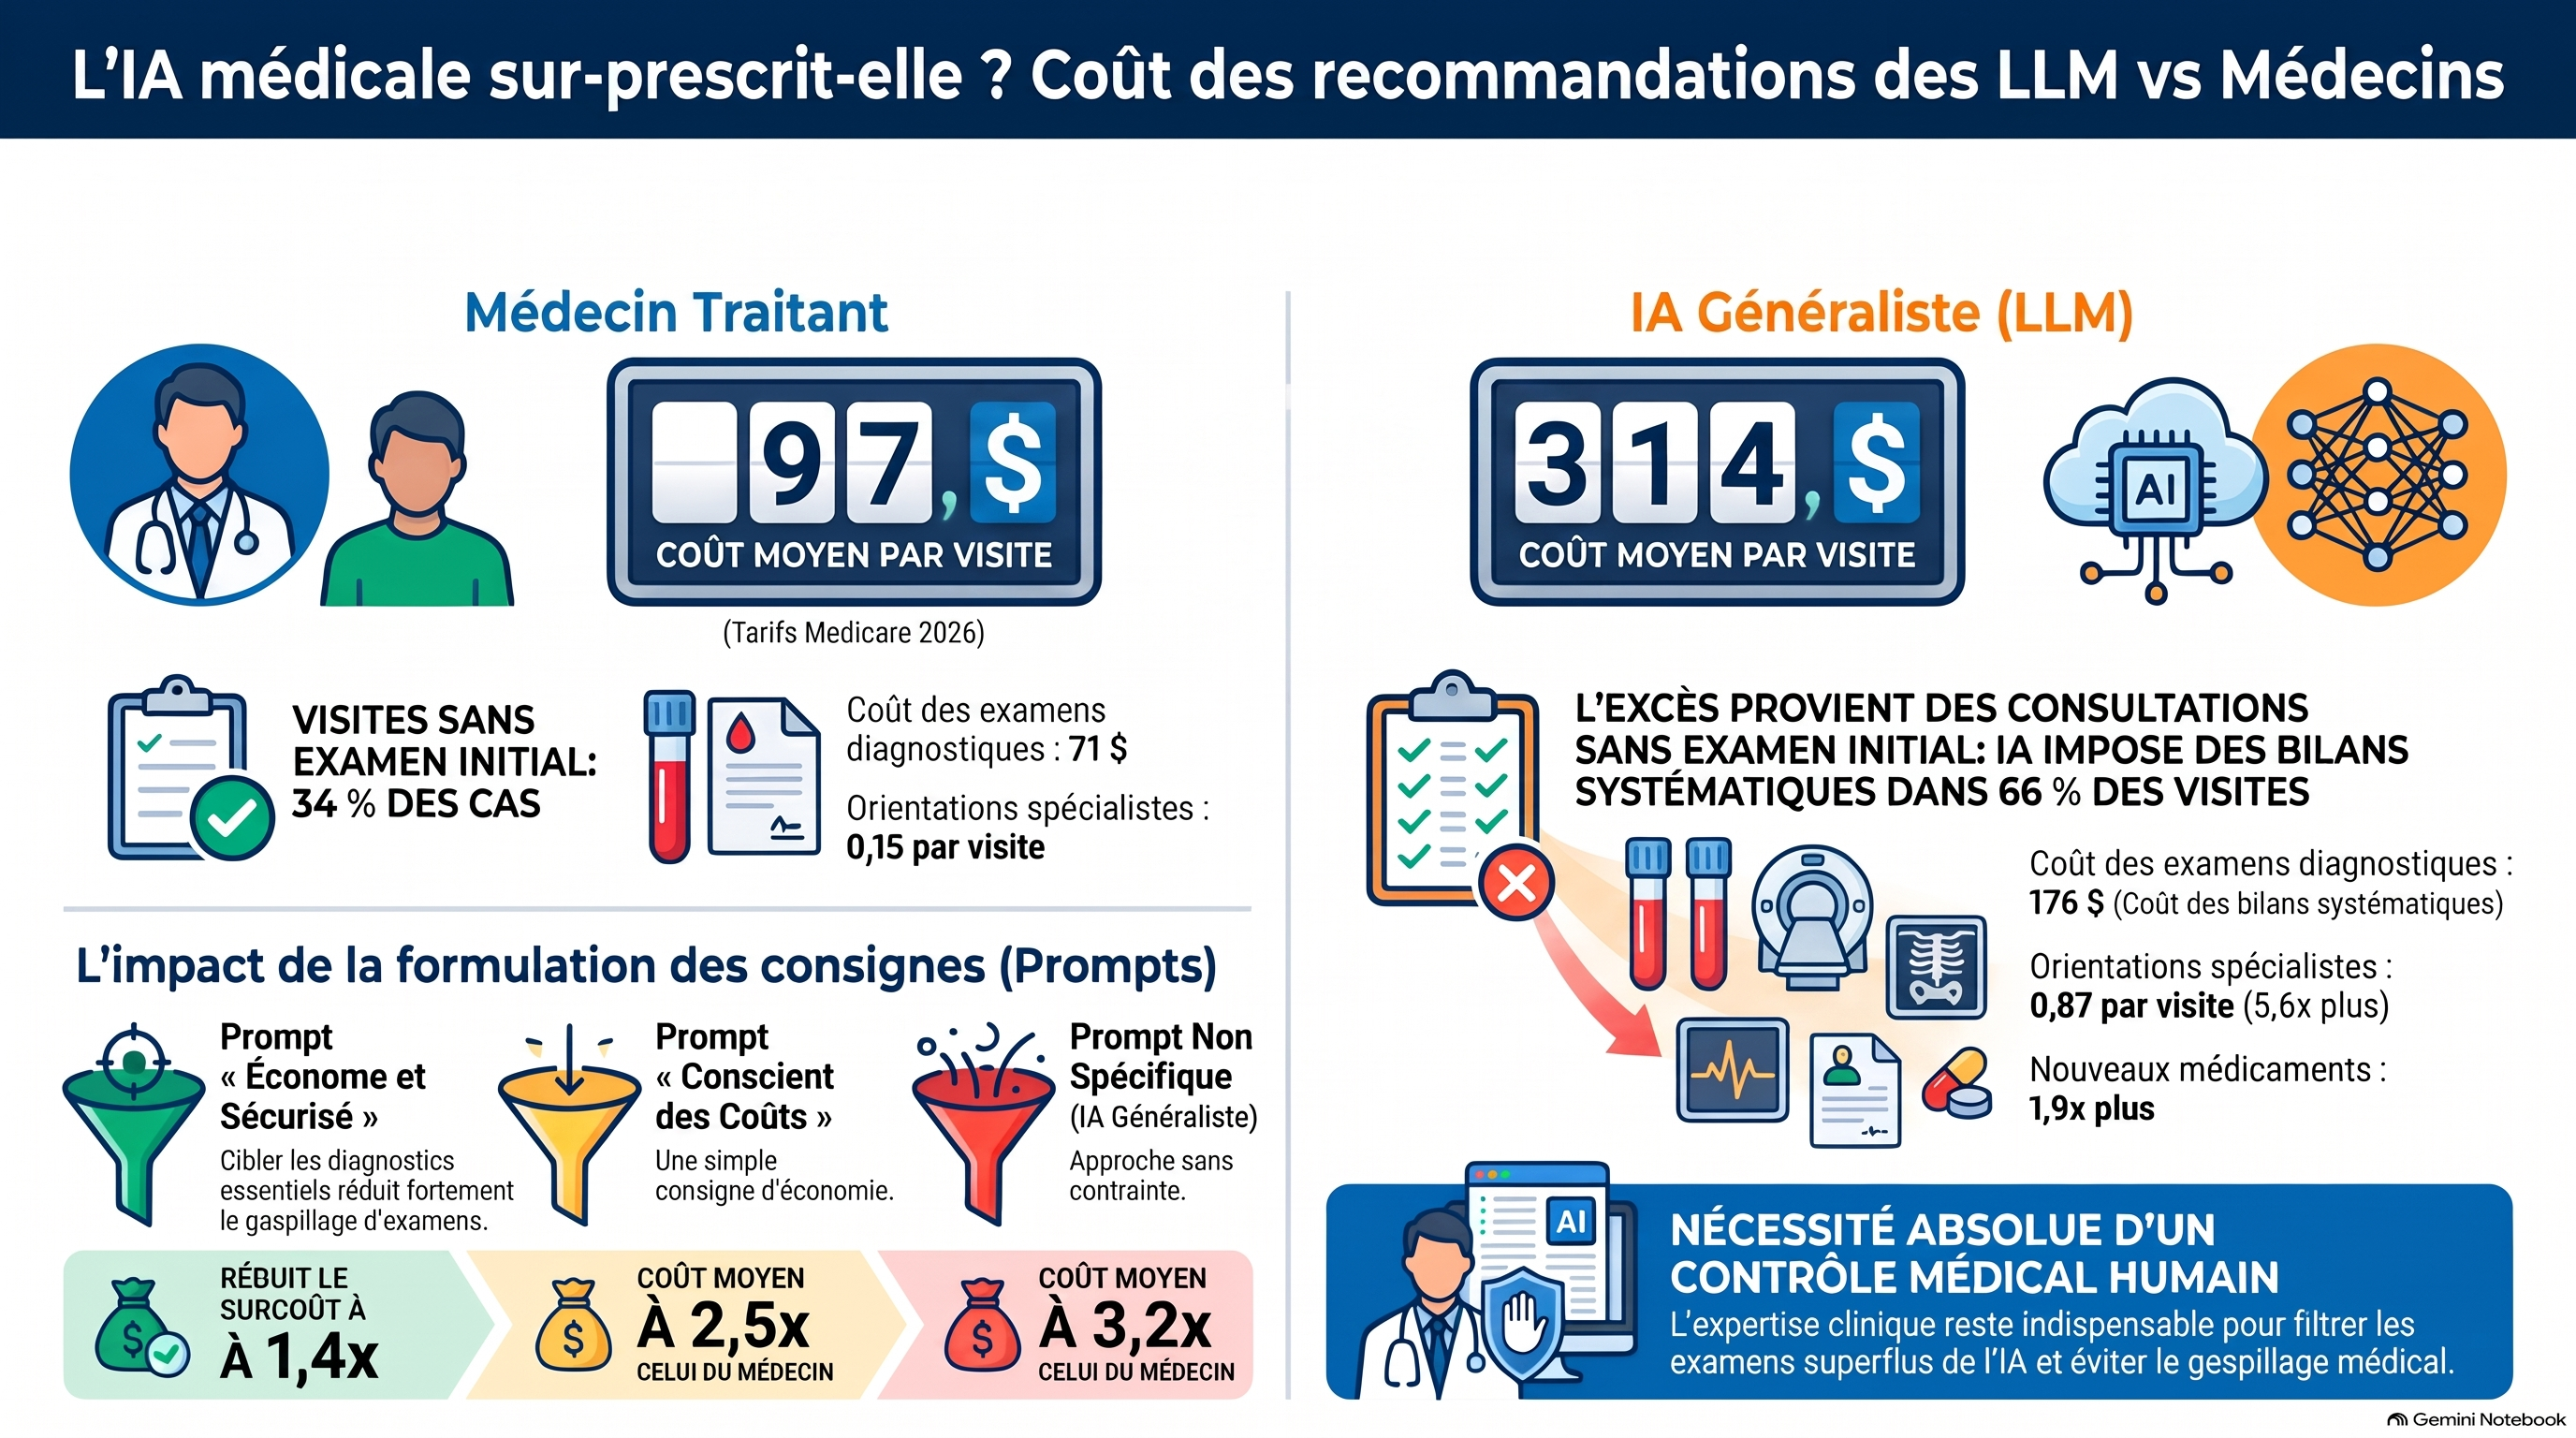
- * Les systèmes d'IA suggèrent en moyenne des soins coûtant 3,2 fois plus que ceux documentés par les médecins (US$314 contre US$97).
- * La principale différence provient de recommandations excessives de tests et de références spécialisées souvent inutiles.
Méthodologie d’évaluation
- * 200 notes cliniques déidentifiées ont été analysées, avec 24 systèmes d’IA et un pipeline d’extraction et de tarification identique.
- * Les coûts ont été calculés selon le tarif Medicare 2026 pour les tests et références, en ignorant les médicaments.
Résultats et surcoûts de l'IA
- * Les recommandations de l’IA sont en moyenne 3,3 fois plus coûteuses, avec une variation de 2,5 à 6,3 fois selon les modèles.
- * La majorité des systèmes préconisent davantage de tests (US$105 en plus par visite) et de références (US$111 en plus), avec plus de médicaments prescrits.
- *La surcoût est surtout dû aux tests ajoutés lors de visites où le médecin n’a recommandé aucun examen.
Impact des prompts et stratégies d’atténuation
- * Des prompts « conscience des coûts » ou « parcimonie et sécurité » ont réduit la dépense de 3,2 à 1,4 fois le budget du médecin.
- * La réduction des recommandations conduit cependant à une baisse de l’accord avec le diagnostic initial, sans éliminer complètement le dépassement de coût.
Patterns de recommandations excessives
- * AI propose souvent un panel de dépistage systématique, une prise de sang complète ou test thyroïdien, indépendamment du contexte.
- * 21 % des systèmes suggèrent 8 tests ou plus pour une seule visite. La majorité de ces tests sont de faible rendement ou inutiles selon des revues médicales.
Revue clinique sur les recommandations inappropriées
- * 5 % des plans AI sont clairement inutiles, et une majorité est raisonnable mais peu rentable ou conforme aux guidelines.
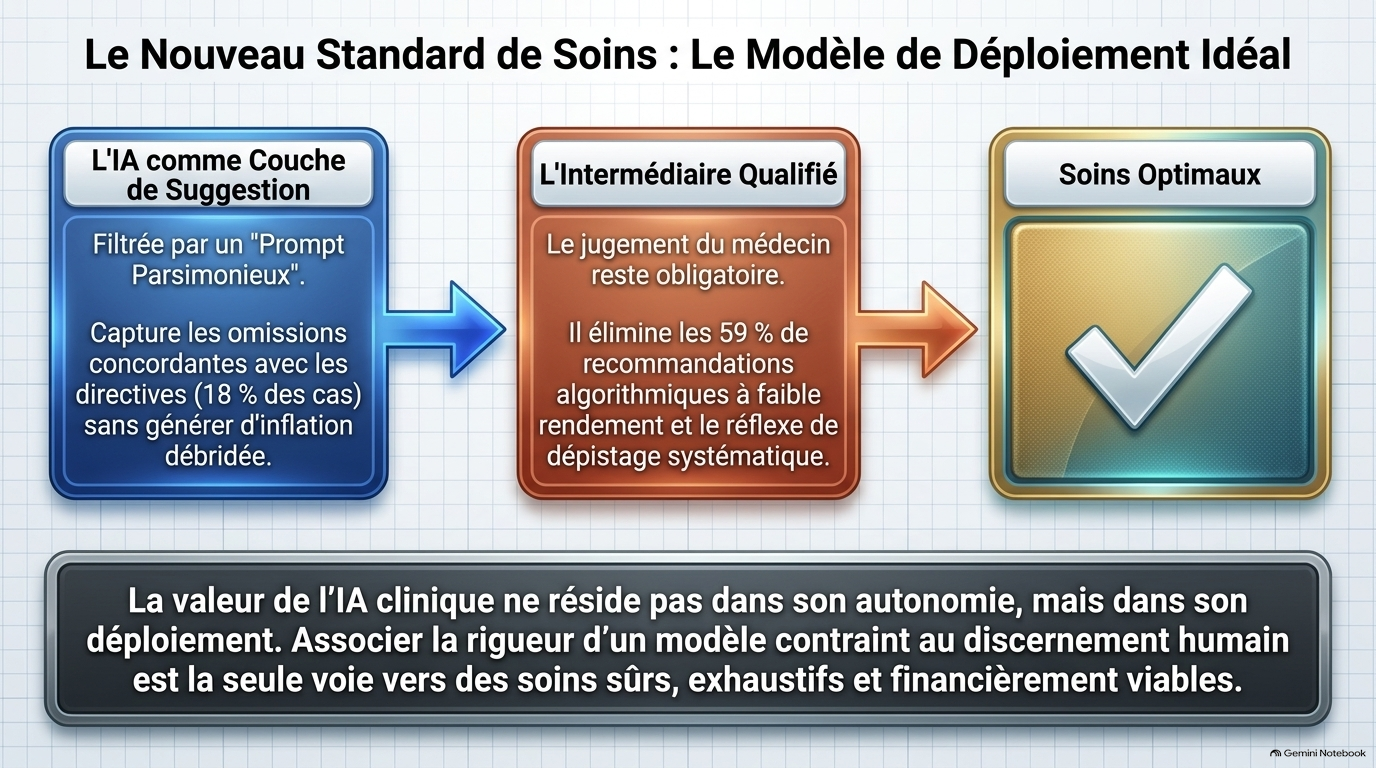
- * Environ 18 % des ajouts conformes aux recommandations sont parfois omis par l’IA, mais la majorité reste défendable.
Effets des versions et mise au point
- * Les nouvelles versions de modèles ne réduisent pas systématiquement les coûts, mais certaines favorisent des recommandations plus économes.
- * Les stratégies visant à réduire l’excès sans compromettre la sécurité montrent que l’ajustement des prompts peut modérer les dépenses excessives.
Surplus de recommandations des systèmes IA
- * Les modèles généralisés suggèrent plus de tests, médicaments et références que les médecins.
- *La génération successive n’a pas réduit cette tendance, augmentant ainsi les coûts et l’incertitude.
Impact du prompt sur la dépense
- * Un prompt prudent réduit la dépense moyenne de 3,2 à 1,4 fois la consultation du médecin.
- * La façon dont les questions sont formulées influence fortement la sur-ordonnance AI.
Comportement comparé à la médecine défensive
- * Les IA reflètent une tendance à la surinterprétation similaire à la médecine défensive humaine.
- * Contrairement aux médecins, les IA favorisent souvent une évaluation exhaustive dès le départ.
Prescription et recommandations excessives
- * Les systèmes ajoutent souvent des tests non nécessaires et prescrivent plusieurs médicaments redondants.
- * Plus de références peuvent entraîner une surcharge de soins et des délais accrus.
Limites de l’étude et implications
- La base de données n’est pas totalement représentative et le coût total peut être surestimé.
- La mobiliser avec supervision et prompt à coût maîtrisé est essentiel pour un usage sûr.
GEMINI IA

L'expertise médicale classique enfin reconnue dans cet article IA . Le médecin a besoin d'une assistance IA, ce que j'approuve, mais une fois de plus, la modération humaine s'impose sans discussion. Prescrire un médicament est un acte majeur ; les patients se montrent de plus en plus méfiants envers un nouveau traitement, il faut donc expliquer et réexpliquer. Il en est de même des examens paracliniques. Que l'IA donne des pistes diagnostiques et thérapeutiques , oui, mais la responsabilité de ces actes est du ressort du médecin. Le contrôle humain reste la base de l'acte médical dans le cadre de la pertinence des soins. Or l'IA ne connaît pas la pertinence des soins, une IA, c'est l'impertinence des soins . Voilà le point majeur de cet article.